发布日期:09-24
企业准备引入人工智能时,最容易问的一个问题是:
哪个模型最好?
但真正进入企业级AI项目之后会发现,模型只是整个系统中的一个环节。
模型在哪里训练?
企业数据从哪里获取?
算力如何调度?
模型怎样连接原有业务系统?
哪些员工可以访问数据?
推理成本如何控制?
敏感信息能不能进入公共云?
模型输出出现错误之后如何追踪?
这些问题最终共同决定一项人工智能技术能不能从演示环境真正进入企业经营。
因此,企业AI落地并不是简单部署一个算法,而是人工智能、云计算、数据平台、安全体系和业务流程共同组成的系统工程。
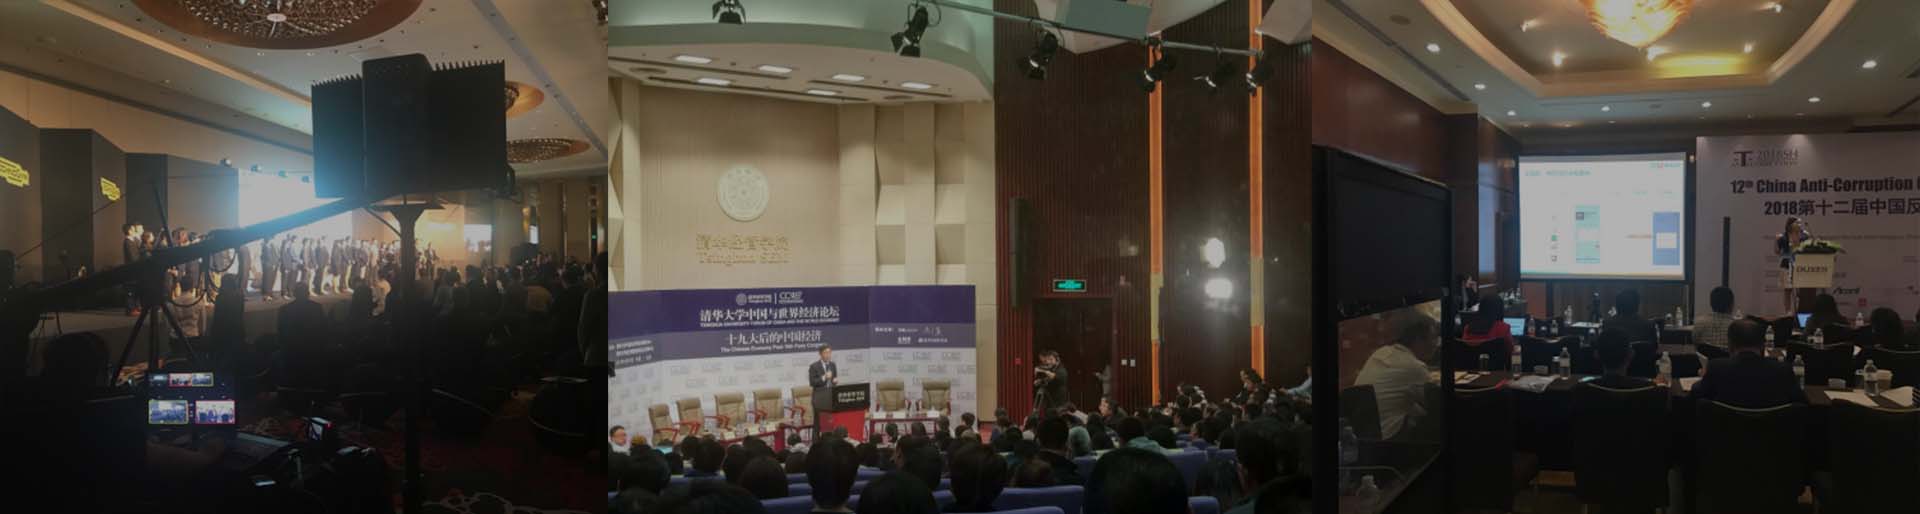
在杭州国际博览中心举行的人工智能云峰会上,与会企业和技术团队围绕人工智能、云计算、数据应用及企业数字化展开交流。
心译翻译为相关会议提供专业语言支持,协助中外嘉宾准确传递技术观点、产品能力及合作需求。
相关项目可查看:人工智能云峰会翻译案例(/case/41.html)。
人工智能为什么越来越离不开云计算?
人工智能模型运行需要计算资源。
训练大型模型尤其需要大量GPU或其他加速计算资源,而模型真正投入业务之后,还需要持续处理用户请求。
如果企业完全依赖本地固定服务器,就必须提前准备足够的计算能力。
但实际业务负载往往并不稳定。
有时一天只有几百次调用;
有时产品上线后可能突然增长到数万甚至更多请求。
云计算的重要价值之一,就是能够根据需求更加灵活地获得计算、存储、网络及软件资源。
美国国家标准与技术研究院 NIST 对云计算的经典定义强调,云计算通过网络按需提供共享的可配置计算资源,并可以快速配置和释放资源。NIST同时将按需自助服务、资源池化、快速弹性等作为云计算的重要特征。
这也解释了为什么人工智能与云计算越来越紧密地结合。
AI需要计算资源,而云平台提供:
**Compute
Storage
Networking
Data
AI Services**
即:
**计算
存储
网络
数据
AI服务。**
模型训练和模型部署并不是一回事
人工智能会议中经常同时出现两个概念:
training
和
inference。
训练是模型通过数据学习参数的过程。
推理则是训练完成之后,模型根据新的输入产生结果。
例如,一个工业视觉模型可能使用大量缺陷图片完成训练。
真正进入生产线之后,它每天需要完成的是:
识别新的产品图像是否存在缺陷。
后面的过程就是推理。
因此:
Training ≠ Inference
两者对计算资源、成本和系统架构的要求也可能不同。
训练阶段可能需要短时间集中使用大量算力;
推理阶段则更关注:
响应速度;
并发能力;
稳定性;
单位调用成本。
对于企业而言,“能把模型训练出来”和“能够让模型长期稳定服务真实用户”是两个完全不同的问题。
为什么一个实验室里表现优秀的模型,进入企业后可能不好用?
人工智能项目经常出现一种情况:
Demo效果非常好。
真正部署之后却出现各种问题。
原因在于实验环境和真实业务环境之间存在巨大差异。
实验数据往往相对干净。
真实企业数据却可能存在:
缺失;
错误;
格式不一致;
重复;
历史系统差异;
权限限制。
真实用户提出的问题也可能比测试环境复杂得多。
因此,一套AI系统进入生产环境,需要解决的不只是:
Model Accuracy
还包括:
Availability
Latency
Scalability
Security
Cost
Monitoring
即:
可用性
延迟
扩展能力
安全
成本
监控。
这也是为什么AI工程与单纯算法研究之间存在明显区别。
企业AI真正困难的地方,往往是数据
没有数据,人工智能很难真正理解企业业务。
例如一家企业希望建立AI客服。
模型本身可能已经具备很强的语言能力。
但它仍然不知道:
企业有哪些产品;
价格是多少;
售后规则是什么;
客户历史订单在哪里;
哪些内容可以公开;
哪些信息属于内部机密。
因此,企业需要考虑如何让AI安全地访问:
产品数据库;
知识库;
CRM;
ERP;
文档系统;
客服记录。
这时,问题已经从:
“模型够不够聪明?”
变成:
“模型能够访问什么数据?”
而进一步还要问:
谁允许它访问?
数据进入AI之前为什么需要治理?
企业内部并不是所有数据都可以被所有员工访问。
AI也一样。
例如:
普通客服人员可以查询产品说明;
财务数据可能只能由财务人员访问;
员工个人信息具有更加严格的权限;
客户合同也不应该被无关人员读取。
如果AI系统绕过原有权限体系,就可能产生新的安全风险。
因此,企业AI架构通常需要考虑:
身份认证;
访问权限;
数据分类;
日志记录;
敏感信息保护;
数据生命周期。
所以,真正成熟的AI系统不是:
AI + All Data
而是:
AI + Authorized Data
即:
AI + 被授权的数据。
公有云、私有云和本地部署为什么经常一起讨论?
企业在AI项目中还需要决定:
模型运行在哪里。
常见方式包括:
Public Cloud;
Private Cloud;
On-premises;
Hybrid Cloud。
也就是:
公有云;
私有云;
本地部署;
混合云。
不同部署方式并不存在适用于所有企业的唯一答案。
企业需要结合:
数据敏感程度;
计算需求;
监管要求;
现有IT系统;
成本;
业务规模
进行判断。
例如,一些普通营销内容生成任务可以使用云端服务。
而涉及高度敏感数据的企业,可能希望部分模型或数据保留在更加受控的环境。
因此,AI部署讨论的核心并不是简单:
云好还是本地好?
而是:
哪些工作负载应该放在哪里?
为什么越来越多企业采用混合架构?
现实中的大型企业往往已经拥有大量历史IT系统。
不可能因为采用AI,就把所有系统全部重新建设。
于是更加常见的情况可能是:
核心数据库仍然存在企业内部;
部分计算资源使用云平台;
AI模型通过API提供服务;
部分敏感业务采用私有环境;
不同系统之间通过接口连接。
这就形成了复杂的混合架构。
因此,企业AI建设通常不是:
Replace Everything
而更接近:
Integrate Everything。
即:
不是全部替换,而是逐步整合。
这也是大型企业数字化项目为什么经常需要系统架构能力,而不仅仅是算法工程师。
AI为什么正在从“模型能力竞争”进入“系统能力竞争”?
早期人工智能讨论经常集中在:
哪个模型参数更多;
哪个模型准确率更高;
哪个模型能力更强。
但企业真正采用AI之后,关注点会逐渐变化。
企业更加关心:
能不能接入现有系统;
响应速度够不够;
数据是否安全;
调用成本是多少;
员工是否真正使用;
出现问题能不能追踪;
系统能不能持续升级。
因此,企业级AI竞争越来越不仅是:
Model Capability
还包括:
**Infrastructure
Data
Integration
Governance
Operations**
也就是:
**基础设施
数据
系统集成
治理
运营。**
一个非常强大的模型,如果不能进入企业真实工作流,其商业价值仍然有限。
AI应用为什么需要持续监控?
传统软件通常按照明确规则运行。
输入A,系统按照程序逻辑产生B。
AI系统却可能具有概率性。
尤其是生成式人工智能,面对不同输入时可能产生不同回答。
因此,企业不能在模型上线之后就结束项目。
还需要持续观察:
输出质量;
错误率;
响应速度;
用户反馈;
安全事件;
模型成本;
数据变化。
如果企业业务发生变化,原有知识库也需要更新。
因此,AI部署更加接近:
Deploy
→ Monitor
→ Evaluate
→ Improve
→ Deploy Again
即:
部署
→ 监控
→ 评估
→ 改进
→ 再部署。
人工智能系统实际上是一个持续运营的产品。
AI风险治理为什么开始进入企业技术架构?
随着AI进入越来越多业务场景,企业关注的问题也不再只有“能不能用”。
还包括:
是否可靠;
是否安全;
是否存在隐私风险;
结果能否解释;
谁对AI决策负责;
发生问题以后如何调查。
NIST的 Artificial Intelligence Risk Management Framework(AI RMF)就是为设计、开发、部署和使用AI系统的组织提供风险管理框架,帮助组织把可信性因素纳入AI产品和系统的设计、开发、使用及评估过程。
NIST同时强调,AI系统的可信性需要考虑包括:
有效与可靠;
安全;
安全与韧性;
透明与问责;
可解释性;
隐私保护;
有害偏差管理
等多个维度。
这说明企业AI建设正在从:
“这个模型能不能工作?”
逐渐发展到:
“这个系统能不能被可靠地长期使用?”
生成式AI为什么进一步提高了治理要求?
传统AI往往针对特定任务。
例如:
预测销量;
判断缺陷;
识别欺诈。
生成式AI则可以直接生成:
文字;
图片;
代码;
摘要;
分析结果。
它的应用范围更广,但输出也更具有开放性。
因此,企业需要进一步考虑:
模型是否产生错误信息;
员工是否输入敏感数据;
输出是否涉及知识产权问题;
哪些内容需要人工审核;
模型是否可以直接执行业务操作。
NIST已经针对生成式人工智能发布专门的 Generative AI Profile,用于帮助组织识别生成式AI特有的风险并采取相应风险管理措施。
所以企业引入生成式AI时,一个越来越重要的原则是:
Human in the Loop
即:
在关键业务环节保留必要的人工参与和判断。
AI会议翻译为什么不能只准备“人工智能词汇”?
人工智能云峰会涉及的内容通常远远超过AI本身。
一位嘉宾可能谈:
large language model;
下一位嘉宾开始介绍:
GPU cluster;
之后又进入:
data lake;
API;
cloud-native;
cybersecurity;
access control。
一场人工智能云计算会议可能同时跨越:
**AI
Cloud Computing
Data Engineering
Cybersecurity
Enterprise Software**
也就是:
**人工智能
云计算
数据工程
网络安全
企业软件。**
因此,专业人工智能会议翻译不能只建立一张AI术语表。
译员还需要理解这些技术之间为什么能够连接起来。
训练、微调、推理和RAG为什么不能混在一起?
人工智能领域技术更新速度很快,大量概念容易在大众传播中被混用。
例如:
pre-training;
fine-tuning;
inference;
RAG;
prompt engineering。
它们并不是同一件事。
预训练主要建立模型基础能力;
微调针对特定数据进一步调整模型;
推理是模型真正接受输入并产生输出;
RAG则通常通过检索外部信息,为模型提供与当前任务相关的上下文。
如果翻译只看到“AI训练”就把这些概念全部统一处理,很容易改变技术含义。
因此,科技会议翻译需要做到的不只是:
Term Accuracy
还需要:
Architecture Understanding。
也就是:
术语准确 + 架构理解。
为什么产品名称和技术缩写特别需要提前统一?
AI和云计算行业存在大量:
产品名称;
平台名称;
模型名称;
服务名称;
技术缩写。
例如:
API;
GPU;
LLM;
RAG;
SaaS;
PaaS;
IaaS;
MLOps。
这些缩写如果现场第一次听到,很容易与其他概念混淆。
尤其是企业自有产品名称,有时候并不存在通用译法。
因此,科技峰会会前准备通常需要建立:
**Company List
Product List
Acronym List
Technical Glossary**
即:
**企业名称表
产品名称表
缩写表
技术术语表。**
这样才能确保PPT、口译和后续新闻稿中的表达保持一致。
科技内容传播为什么要根据受众重新表达?
人工智能企业经常同时面对四类受众:
技术人员;
企业客户;
投资者;
普通公众。
他们关心的并不是同一件事。
技术人员关心:
系统怎么实现。
企业客户关心:
能解决什么问题。
投资人关心:
市场和商业模式。
公众可能首先关心:
AI到底会带来什么改变。
因此,一份技术演讲不能原封不动地复制到所有传播渠道。
真正有效的科技传播需要完成:
Technical Information
→ Audience Context
→ Appropriate Expression
也就是:
技术信息
→ 判断受众
→ 重新组织表达。
但重新表达并不意味着改变技术事实。
从一次峰会到企业完整国际传播
人工智能企业真正进入国际市场以后,需要处理的内容通常越来越多。
除了会议口译,还包括:
技术白皮书;
产品手册;
API文档;
官方网站;
软件界面;
融资材料;
案例研究;
演示文稿;
新闻稿;
技术视频;
海外社交媒体。
如果这些资料由不同团队分别翻译,又没有统一术语体系,就容易出现:
同一个功能多个名称;
同一个模型不同译法;
市场材料和技术资料相互矛盾;
销售人员使用的表达与产品界面不同。
因此,科技企业国际化需要逐渐建立自己的:
**Technical Terminology
Style Guide
Translation Memory
Content Workflow**
即:
**技术术语库
语言风格指南
翻译记忆库
内容工作流。**
结语:企业AI真正需要建设的是一套能够长期运行的系统
人工智能模型能力正在快速提升。
但对于企业而言,真正决定AI能不能创造价值的,并不只是模型排行榜上的成绩。
它还取决于:
有没有稳定算力;
数据能不能正确访问;
系统能不能连接;
成本能不能控制;
安全能不能保证;
风险能不能管理;
员工是否真正使用。
因此,企业AI落地更完整的链条应该是:
Model
→ Compute
→ Data
→ Deployment
→ Integration
→ Governance
→ Business Value
即:
模型
→ 算力
→ 数据
→ 部署
→ 集成
→ 治理
→ 业务价值。
人工智能真正进入产业,不是让企业“拥有一个AI”。
而是让AI成为企业原有业务系统中可以被稳定、安全和持续使用的一部分。
心译翻译可为人工智能、云计算、软件、数据平台及企业数字化项目提供科技会议同声传译、人工智能技术资料翻译、云计算文档翻译、产品演示文稿本地化、软件及平台内容翻译、技术白皮书翻译以及多语种科技国际传播支持,帮助复杂技术从研发团队更加准确地进入客户、市场与全球合作场景。