发布日期:09-29
人工智能快速发展之后,决定模型性能的已经不只是算法。
底层计算能力、存储带宽、功耗和芯片架构,正在直接影响AI系统能够运行多大的模型、实现多快的推理速度,以及最终的部署成本。
NIST指出,芯片是人工智能等现代计算技术的重要基础;IEEE则将AI加速器定义为专门用于提高AI和机器学习计算吞吐量及能效的硬件。NIST
因此,AI芯片翻译、半导体会议翻译和人工智能硬件同声传译,已经成为科技与先进制造专业语言服务中的高技术门槛方向。
AI Accelerator是什么意思?
AI Accelerator
人工智能加速器。
它通常指针对人工智能工作负载进行优化的硬件。
神经网络大量涉及:
矩阵乘法;
向量运算;
并行计算。
AI加速器通过专门架构提高这些运算的执行效率。
IEEE指出,现代AI加速器通常需要在峰值吞吐量、内存带宽、功耗和可编程性之间进行权衡。IEEE Technology Navigator
CPU和GPU有什么区别?
CPU — Central Processing Unit
中央处理器
更适合处理复杂逻辑、串行任务和通用计算。
GPU — Graphics Processing Unit
图形处理器
拥有大量并行计算单元,因此非常适合神经网络中的大规模并行运算。
GPU最初主要用于图形计算,但后来逐渐成为AI训练的重要硬件平台。IEEE关于神经网络硬件的资料也指出,GPU是最早被广泛采用的AI加速硬件之一。IEEE Technology Navigator
FPGA为什么具有可重构优势?
FPGA — Field-programmable Gate Array
现场可编程门阵列。
它的特点是:
硬件逻辑可以重新配置。
这意味着企业可以根据不同AI算法和应用需求调整计算结构。
相比GPU,FPGA通常更加专用;
相比ASIC,又具有更强的灵活性。
因此,它经常用于:
边缘计算;
低延迟系统;
定制AI推理。
ASIC为什么适合专用AI计算?
ASIC — Application-specific Integrated Circuit
专用集成电路。
ASIC从设计阶段就针对特定应用优化。
IEEE指出,AI领域的ASIC通常通过针对矩阵乘法和数据流进行硬件优化,以获得较高能效。IEEE Technology Navigator
典型AI ASIC可能专门面向:
训练;
推理;
视觉计算;
语音处理;
数据中心AI。
相比通用芯片,它的优势通常在于性能功耗比,而代价是灵活性较低。
TPU是什么?
TPU — Tensor Processing Unit
张量处理单元。
它是一类针对机器学习工作负载设计的专用AI芯片。
其核心目标之一,是提高矩阵和张量运算效率。
类似的专用加速器体现了AI芯片发展的一个重要方向:
从通用计算走向专用计算。
专业会议翻译中,不能简单把TPU、GPU和ASIC都处理成“AI芯片”后就忽略架构差异。
TOPS和TFLOPS是什么意思?
AI芯片会议中经常出现:
TOPS — Trillion Operations Per Second
每秒万亿次操作
TFLOPS — Trillion Floating-point Operations Per Second
每秒万亿次浮点运算
两者都用于描述计算能力,但具体计算类型和精度口径可能不同。
例如:
INT8;
FP16;
FP32
对应不同数值精度。
因此,单纯比较“多少TOPS”有时并不能完整说明芯片性能。
译员需要特别注意演讲人是否说明:
运算精度、应用场景和测试条件。
为什么AI芯片特别重视Memory Bandwidth?
现代AI模型需要不断读取大量参数和数据。
因此:
Memory Bandwidth
内存带宽
往往直接影响计算单元能否被充分利用。
会议中还可能出现:
HBM — High Bandwidth Memory
高带宽内存
Cache
缓存
On-chip Memory
片上存储
Memory Hierarchy
存储层级
AI芯片不仅要“算得快”,还要让数据“跟得上”。
为什么AI芯片越来越强调Performance per Watt?
AI计算会消耗大量电力。
因此行业非常关注:
Performance per Watt
每瓦性能
它反映芯片在一定功耗下能够提供多少计算能力。
IEEE关于AI加速器的资料显示,AI硬件设计经常需要在性能与能效之间做权衡。IEEE Technology Navigator
对于数据中心而言,更高能效意味着:
更低电力成本;
更低散热压力;
更高部署密度。
Edge AI是什么?
Edge AI
边缘人工智能。
它指将部分AI计算部署在靠近数据产生端的设备上,而不是全部发送到云端处理。
例如:
智能摄像头;
手机;
汽车;
机器人;
工业设备。
边缘AI通常更加关注:
低功耗;
低延迟;
小型化;
实时响应。
IEEE的AI硬件工作组也明确将云、边缘、嵌入式系统和机器人列为AI基础设施的重要应用场景。AI at IEEE
AI芯片为什么和自动驾驶关系密切?
自动驾驶需要实时处理:
摄像头;
雷达;
激光雷达;
车辆传感器
产生的大量数据。
因此,车载AI芯片通常特别关注:
实时推理;
低延迟;
高可靠性;
功耗;
功能安全。
这也是AI芯片会议经常与汽车电子、机器人和边缘计算交叉的原因。
半导体会议中nm是什么意思?
芯片会议里经常出现:
7nm、5nm、3nm
等工艺节点表达。
它们通常用来描述半导体制造技术代际。
但现代制程节点名称已经不完全等同于芯片上某一个简单物理尺寸。
因此,在专业翻译中最安全的做法是:
保留企业或演讲人使用的正式节点名称,而不要自行解释为某个具体尺寸。
AI芯片会议为什么特别依赖PPT?
芯片演讲通常包含:
架构图;
芯片框图;
性能曲线;
Benchmark;
功耗数据;
制程信息;
模型测试结果。
译员提前获得PPT后,可以快速理解:
数据从哪里进入;
经过什么计算模块;
最终输出什么结果。
这远比单独背诵术语更加有效。
AI芯片会议如何做会前准备?
建议重点准备:
第一,芯片类型。
CPU、GPU、FPGA、ASIC及专用AI加速器。
第二,AI算法。
熟悉训练、推理、CNN、Transformer等基本概念。
第三,硬件指标。
包括TOPS、TFLOPS、功耗及内存带宽。
第四,存储架构。
了解HBM、Cache和片上存储。
第五,应用场景。
判断会议偏数据中心、汽车、边缘设备还是智能终端。
第六,产品与企业名称。
提前确认芯片型号和正式译法。
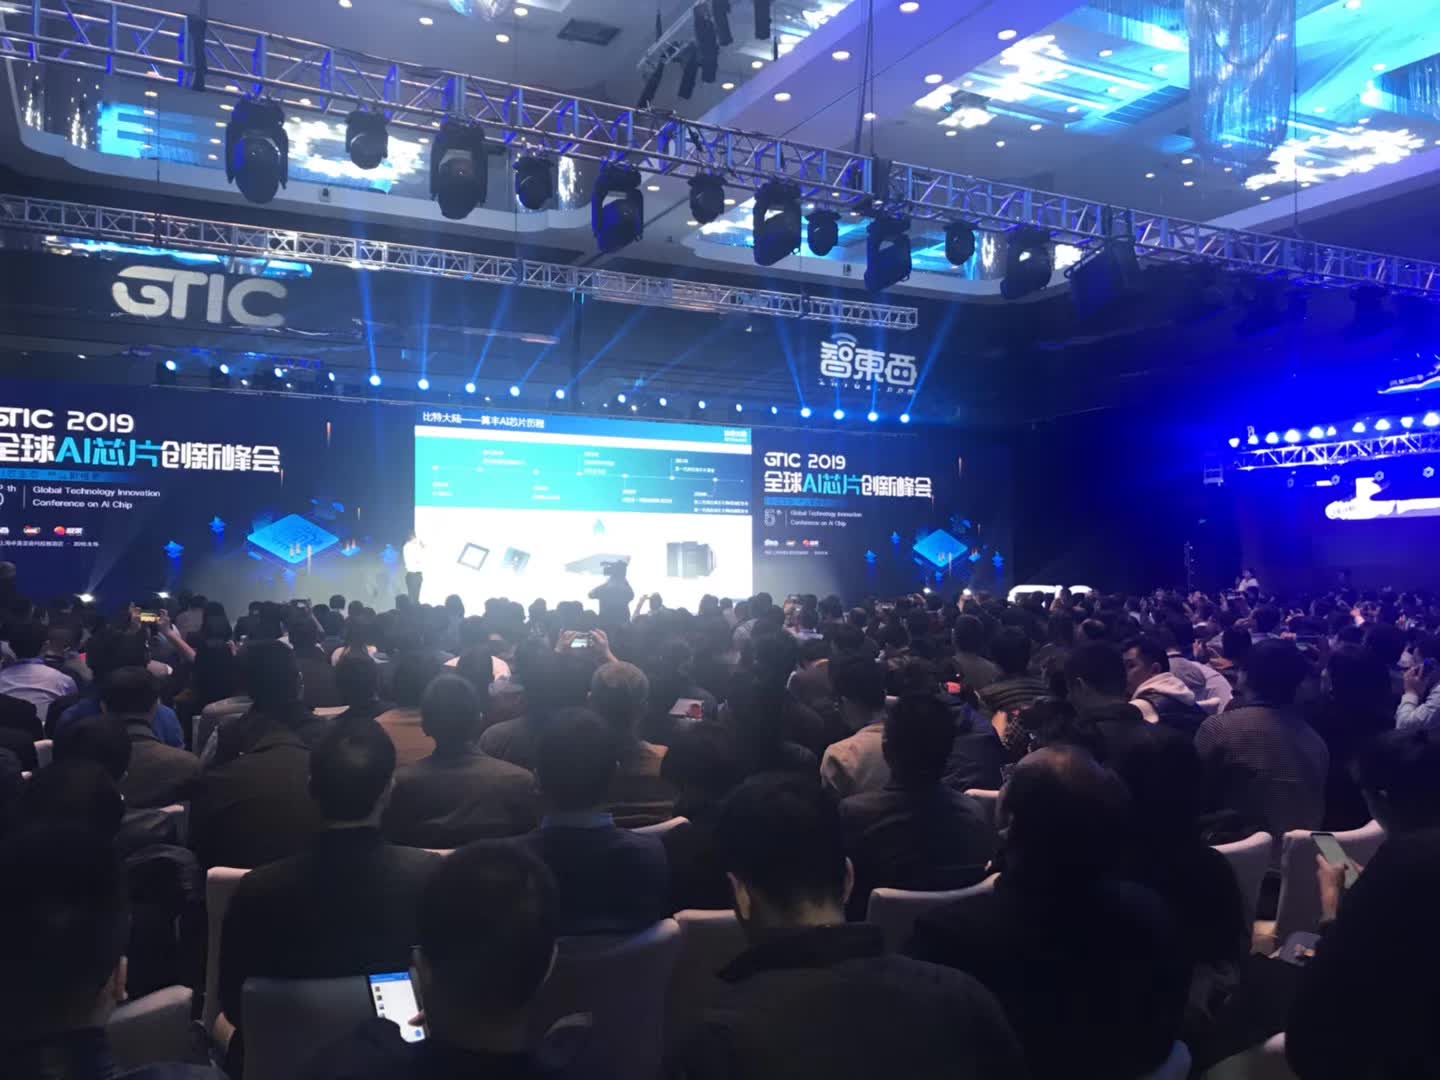
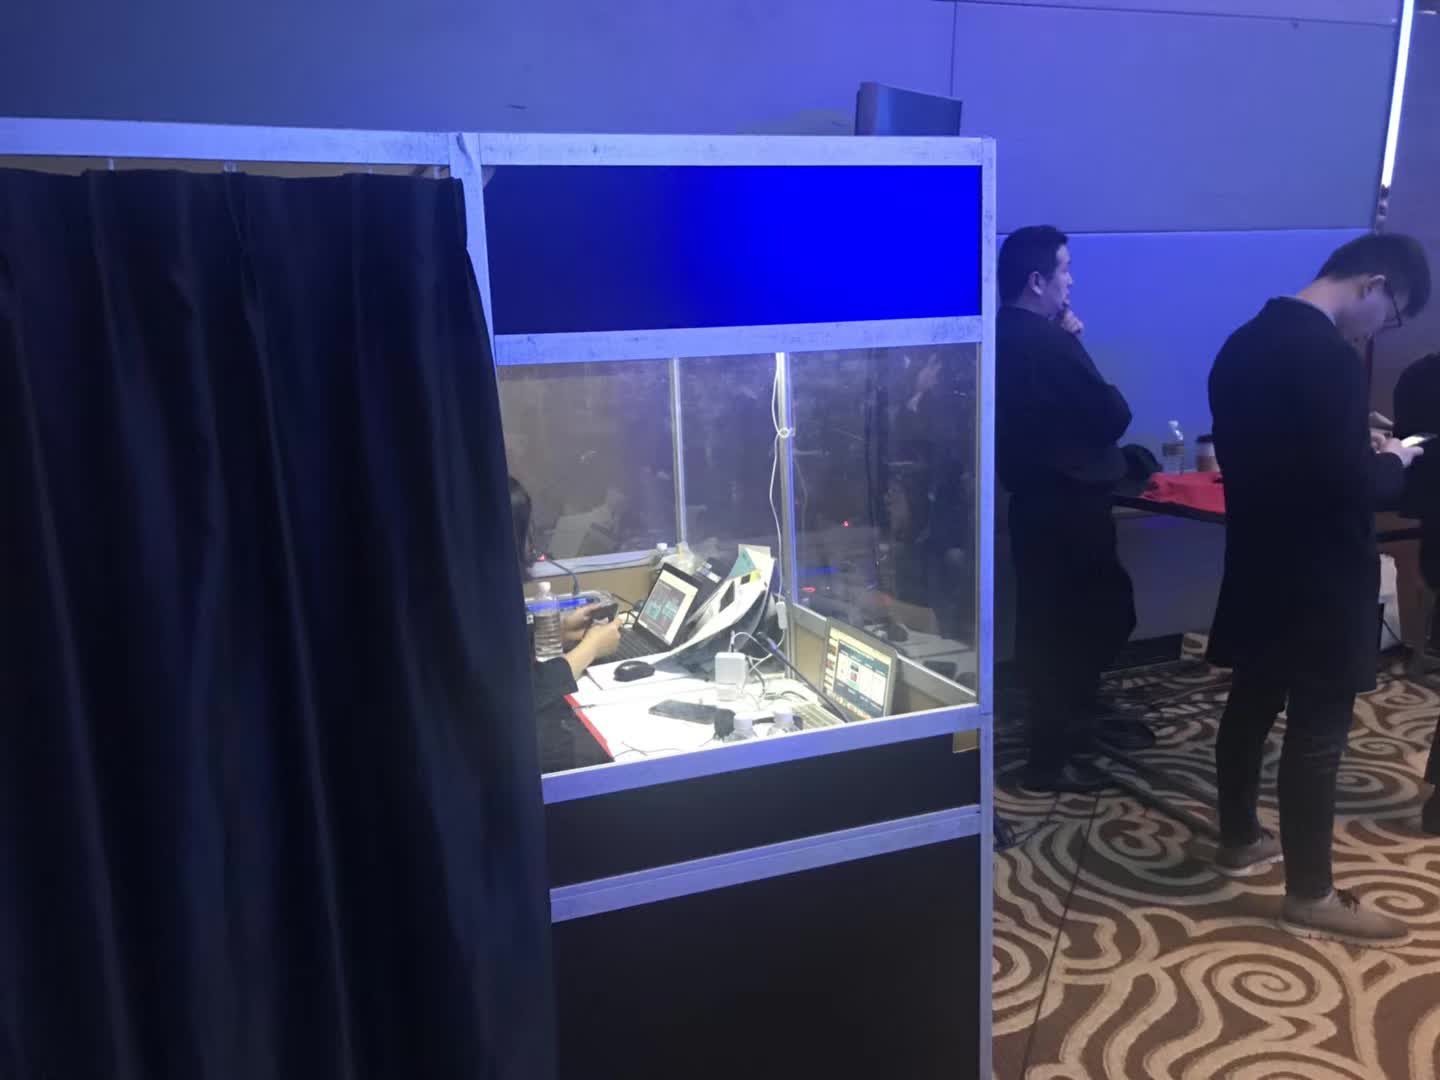
大型峰会还需要配合同传系统与音视频解决方案,确保译员稳定获得现场声音和技术演示。
为什么AI芯片峰会适合同声传译?
芯片大会通常:
技术密度高;
语速快;
缩写多;
参数多;
演讲连续。
采用同声传译、交替传译与高端口译,可以让中外参会者基本同步获取演讲内容。
对于芯片设计评审、企业内部技术交流或商务谈判,则可能更加适合交替传译。
心译翻译:服务AI芯片、半导体与先进制造国际会议
心译翻译长期为人工智能、芯片、半导体、智能制造和科技领域国际会议提供专业语言支持。
针对AI芯片、GPU、FPGA、ASIC、边缘计算、人工智能基础设施和半导体技术等专业内容,可结合技术资料、会议议程及PPT开展充分会前准备。
服务形式涵盖中英同声传译、交替传译、多语种会议口译、专业设备及国际会议整体语言解决方案。