发布日期:09-30
人工智能正在改变内容创作方式,也正在改变知识产权法律讨论的重点。
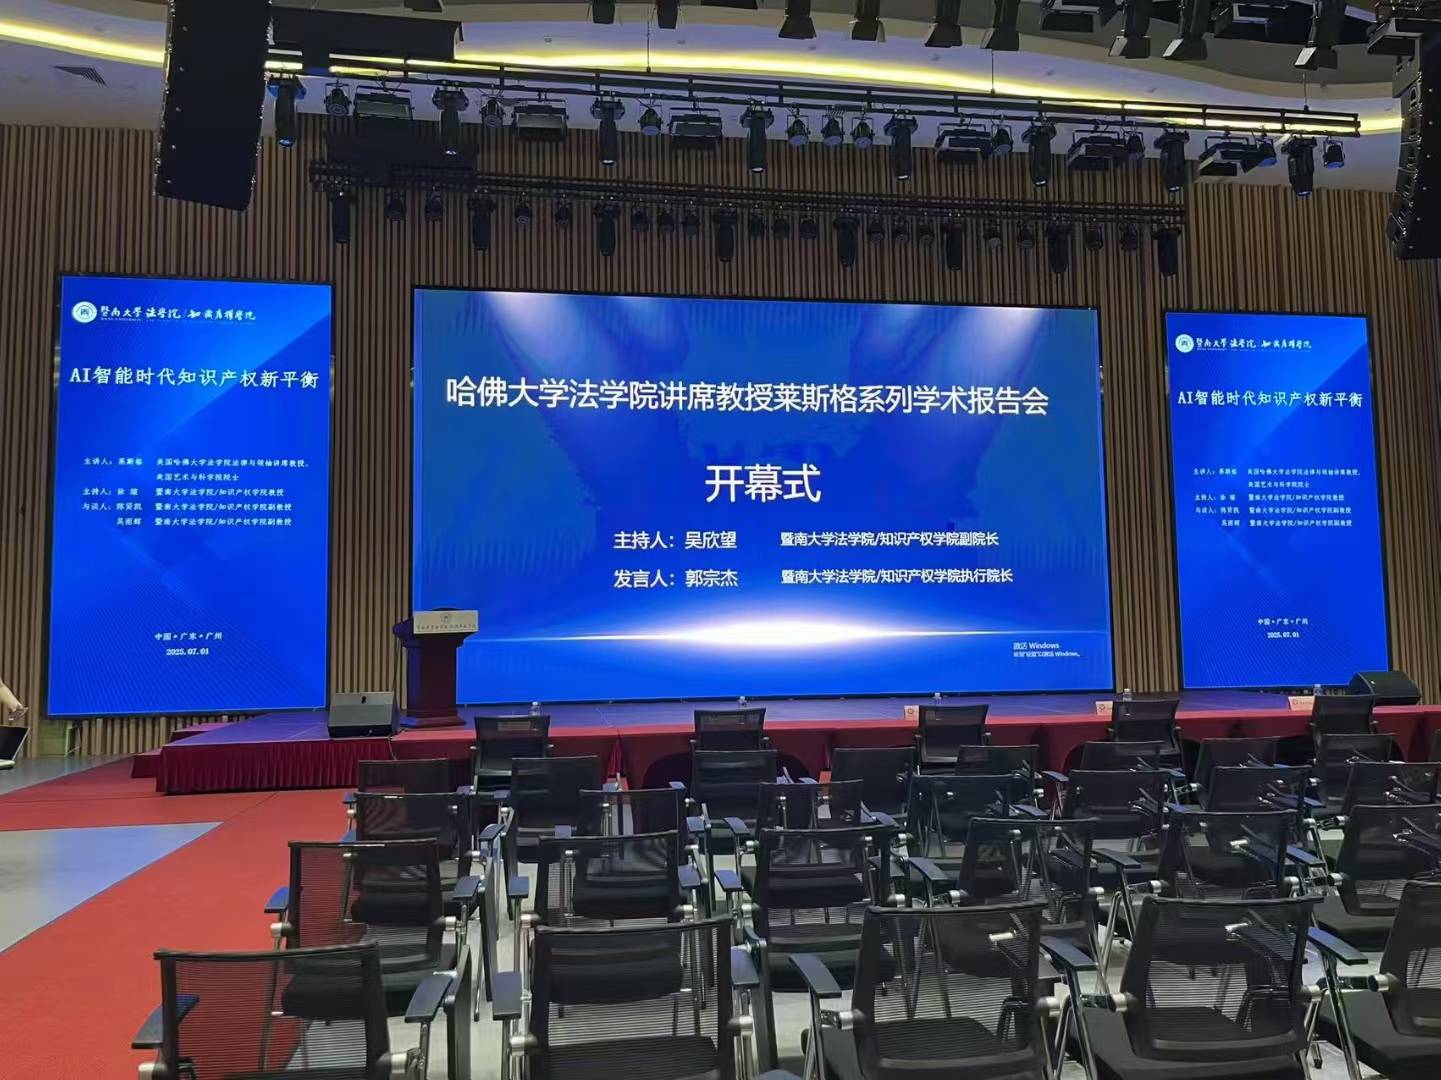
在围绕**“AI智能时代知识产权新平衡”**展开的学术交流中,人工智能、著作权、数据使用及技术创新等问题成为重要议题。
对于译员而言,这类会议的难点并不是单纯“法律词汇很多”。
真正困难的是:
法律、技术和产业语言同时存在。
一、AI知识产权会议为什么特别难翻?
传统知识产权会议主要涉及:
著作权、商标、专利、商业秘密及许可。
但AI会议还会增加:
- machine learning;
- generative AI;
- training data;
- large language model;
- algorithm;
- synthetic content;
- model output。
译员需要在法律与技术两个体系之间不断切换。
二、“训练数据”背后的法律含义并不简单
生成式AI通常需要大量数据进行训练。
问题在于:
这些数据中可能包含受版权保护的文章、图片、音乐、视频或软件代码。
因此,讨论“training data”时,往往同时涉及:
授权、合理使用、复制权、数据抓取、技术创新及权利人利益。
如果译员只懂技术,不懂法律,就可能忽略其中的法律限定。
三、AI生成内容是否具有著作权?
这是目前知识产权领域最受关注的问题之一。
传统著作权制度通常围绕“作者”和“创作行为”建立。
当作品由AI系统生成时,就会出现新的问题:
谁是作者?
用户输入提示词是否构成创作?
模型开发者是否拥有权利?
AI生成内容是否达到作品标准?
这些问题在不同司法辖区也可能存在不同处理方式。
因此,法律会议翻译必须保持表达中立,不应擅自强化某种法律结论。
四、法律翻译为什么特别重视限定词?
法律语言中,一个限定词可能直接改变结论。
例如:
may、shall、generally、under certain circumstances、subject to
都不能随意省略。
同样:
“可能构成侵权”
与
“构成侵权”
法律含义完全不同。
这也是法律会议同声传译特别强调逻辑与语气边界的原因。
五、AI时代知识产权的核心其实是“平衡”
AI与知识产权的冲突,并不是简单的:
“保护作者”与“支持技术”
二选一。
真正的问题是如何在:
创新、投资、创作者权益、公共利益与技术发展
之间建立新的制度平衡。
对于国际会议而言,译员需要准确保留不同嘉宾观点之间的差异,而不能把具有争议的法律判断处理成确定事实。
法律与AI会议应该提前准备什么?
主办方最好提前向语言服务团队提供:
- 会议议程;
- 演讲嘉宾信息;
- PPT;
- 法律文件;
- 论文摘要;
- 案例名称;
- 相关法规;
- AI技术术语。
语言服务团队则需要建立法律与人工智能双重术语库。